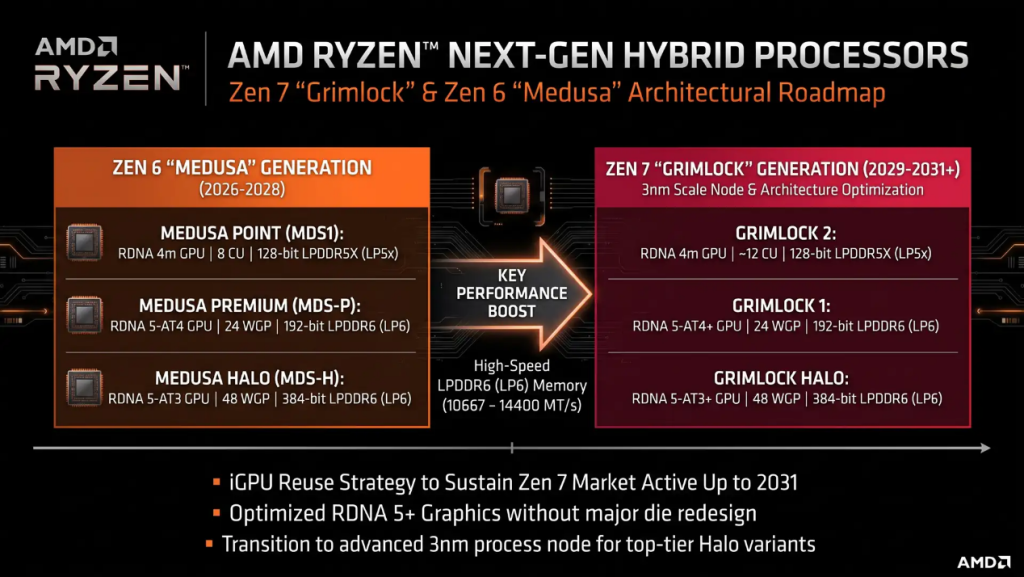
AMD может выпустить мобильные APU поколения Zen 7 под кодовым названием Grimlock в 2029 году. Согласно опубликованным сведениям, старшая модель Grimlock Halo получит интегрированную графику RDNA 5 с 96 вычислительными блоками и поддержку оперативной памяти LPDDR6 с 384-битной шиной. Эти характеристики пока не подтверждены компанией.
Предполагается, что линейка будет разделена на три уровня. Базовые модели Grimlock2, согласно утечке, сохранят графику RDNA 4m и 128-битную память LPDDR5X. Более производительные Grimlock1 получат GPU класса RDNA 5 AT4 с 24 блоками WGP — это соответствует 48 вычислительным блокам CU — и 192-битную шину LPDDR6.
Флагманская Grimlock Halo, по предварительным данным, будет использовать графику класса RDNA 5 AT3 с 48 блоками WGP, или 96 CU, и 384-битную шину LPDDR6. Таким образом, переход на Zen 7 не обязательно будет означать одинаковую графическую конфигурацию для всех APU семейства: младшие версии, как утверждается, останутся на RDNA 4m.
Для старшей модели также приводится оценка пропускной способности памяти от 512 до 691 ГБ/с при скорости передачи данных LPDDR6 от 10 667 до 14 400 МТ/с. Этот диапазон относится именно к 384-битной шине Grimlock Halo. У варианта Grimlock1 с 192-битным интерфейсом те же скорости памяти дали бы теоретические 256–345,6 ГБ/с.
Для сравнения, AMD указывает пропускную способность 256 ГБ/с у Ryzen AI Max+ 395 на базе Strix Halo: процессор использует 256-битную LPDDR5X-8000. Следовательно, верхняя оценка для предполагаемой Grimlock Halo почти в 2,7 раза выше показателя этого APU. Однако речь идёт о расчётной пропускной способности памяти, а не о подтверждённом приросте производительности графики или приложений.
Обозначение RDNA 5+ для будущей графики AMD ранее упоминал аппаратный инсайдер Kepler_L2 в обсуждении на форуме NeoGAF. 26 октября он связал эту версию архитектуры с Grimlock и 2029 годом, но не привёл технических подробностей. AMD, со своей стороны, ранее подтверждала работу над архитектурой Zen 7, однако не объявляла потребительские APU Grimlock, их конфигурации или сроки выхода.
Высокая пропускная способность общей памяти может быть полезна интегрированной графике и локальному запуску больших языковых моделей. При этом одних характеристик шины и количества CU недостаточно, чтобы оценить скорость инференса: также важны вычислительная производительность GPU, объём доступной памяти, энергопотребление и оптимизация программного обеспечения.
Источники: